
Rédigé et vérifié par un professeur diplômé de l’École Polytechnique. Découvrir le professeur
Un GPS qui calcule ton trajet, un réseau d’amis, un web de pages reliées entre elles : derrière chacun se cache un graphe. En Python, savoir le représenter puis le parcourir est au cœur du programme de NSI en Terminale et revient en informatique en prépa. Voici la méthode complète : du dictionnaire d’adjacence aux parcours BFS et DFS, code commenté et déroulé pas à pas.
Au programme
- 🔵 Terminale NSI : structures de données, représentation d’un graphe (dictionnaire, matrice), parcours en largeur et en profondeur.
- 🟠 Prépa (ITC) : représentations, parcours, plus court chemin et algorithme de Dijkstra.
Ne pas confondre « graphe » et « graphique ». Ici, un graphe est un ensemble de sommets reliés par des arêtes (théorie des graphes). Si tu cherches à tracer une courbe de fonction avec matplotlib, c’est un graphique : ce n’est pas le sujet de cette page.
Conventions des programmes : les graphes sont finis et chaque sommet apparaît comme clé du dictionnaire, même s’il n’a pas de voisin. Les fonctions de degré, de comptage d’arêtes et de connexité supposent un graphe simple non orienté : chaque arête figure dans les deux listes. Par convention, notre fonction renvoie False pour le graphe vide.
I. Représenter un graphe en Python
Avant tout parcours, il faut stocker le graphe dans une structure de données. Deux représentations dominent : le dictionnaire d’adjacence (le plus courant en Python) et la matrice d’adjacence.
A. Le dictionnaire d’adjacence
C’est la représentation la plus naturelle : chaque sommet est une clé, et sa valeur est la liste de ses voisins. Prenons le graphe non orienté suivant à cinq sommets.
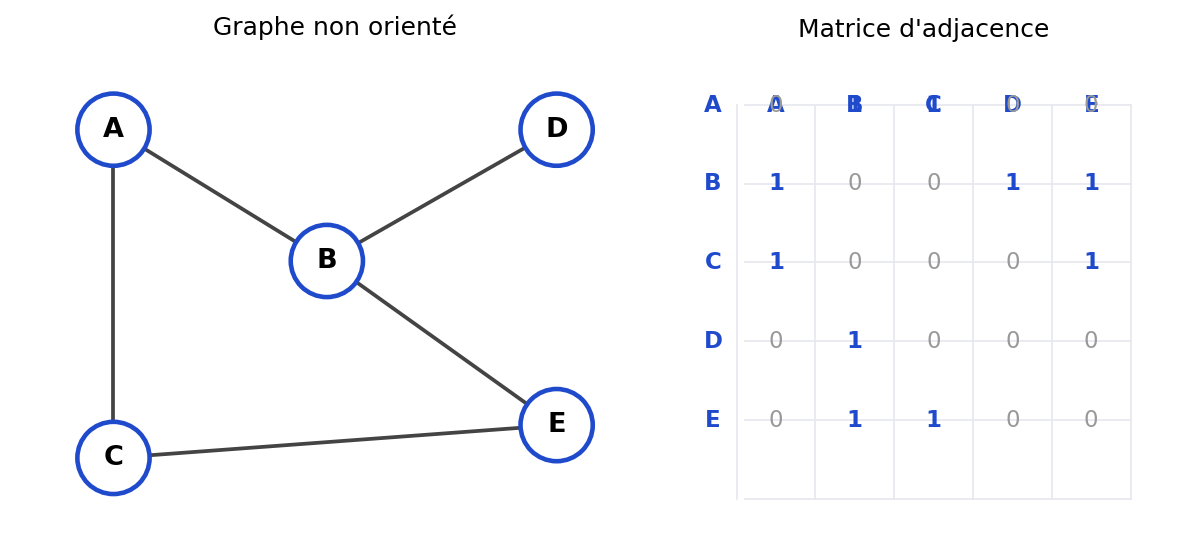
G = {
    'A': ['B', 'C'],
    'B': ['A', 'D', 'E'],
    'C': ['A', 'E'],
    'D': ['B'],
    'E': ['B', 'C']
}
Pour un graphe orienté, on ne met que les arcs sortants : si l’arc va de A vers B, alors 'B' est dans G['A'], mais 'A' n’est pas forcément dans G['B']. Pour un graphe pondéré, on remplace chaque voisin par un couple (voisin, poids).
B. La matrice d’adjacence
La seconde option est une liste de listes : la case M[i][j] vaut 1 s’il existe une arête du sommet i vers le sommet j, et 0 sinon. C’est exactement la matrice d’adjacence du cours de maths, traduite en Python.
# Sommets numérotés 0=A, 1=B, 2=C, 3=D, 4=E
M = [
    [0, 1, 1, 0, 0],   # A
    [1, 0, 0, 1, 1],   # B
    [1, 0, 0, 0, 1],   # C
    [0, 1, 0, 0, 0],   # D
    [0, 1, 1, 0, 0]    # E
]
Pour un graphe non orienté, la matrice est symétrique. Reste à savoir laquelle des deux structures choisir : c’est tout l’objet de la section suivante.
II. Liste ou matrice d’adjacence : que choisir ?
Les deux représentations codent le même graphe, mais elles ne se valent pas selon le nombre d’arêtes et l’opération que tu veux faire. On note \(n\) le nombre de sommets et \(m\) le nombre d’arêtes.
| Critère | Dictionnaire (liste d’adjacence) | Matrice d’adjacence |
|---|---|---|
| Mémoire | \(O(n+m)\) | \(O(n^2)\) |
| Tester si une arête existe | parcourir la liste du sommet | accès direct \(M[i][j]\) |
| Lister les voisins d’un sommet | très rapide | parcourir toute la ligne |
| Idéal pour | graphes creux (peu d’arêtes) | graphes denses, calcul matriciel |
| Lien avec les maths | structure informatique | puissances \(M^k\), nombre de chemins |
Règle simple : en NSI comme en prépa, on utilise par défaut le dictionnaire d’adjacence, économe en mémoire pour les graphes réels (souvent creux). On passe à la matrice quand on veut exploiter le calcul matriciel (par exemple compter les chemins via les puissances).
La fiche méthode « Graphes en Python » en recto-verso
Le code BFS et DFS commenté, le tableau de choix liste/matrice et la fiche de complexité, prêts à imprimer.
📄 Télécharger la fiche PDFTout le cours de graphes à glisser dans ton classeur.
La représentation choisie, on peut maintenant parcourir le graphe. Le premier parcours explore le graphe « couche par couche ».
III. Parcours en largeur (BFS)
Le parcours en largeur (BFS, Breadth-First Search) explore le graphe par cercles concentriques : d’abord le sommet de départ, puis tous ses voisins, puis les voisins des voisins, etc. Il repose sur une file (premier entré, premier sorti).
A. La méthode en 4 étapes
- On marque le sommet de départ comme vu et on le place dans la file.
- On défile un sommet et on l’ajoute à l’ordre de visite.
- Pour chacun de ses voisins non encore vus, on les marque et on les enfile.
- On répète tant que la file n’est pas vide.
from collections import deque

def parcours_largeur(G, depart):
    vus = {depart}             # sommets déjà rencontrés
    file = deque([depart])     # file d'attente
    ordre = []
    while file:
        s = file.popleft()     # on défile (gauche)
        ordre.append(s)
        for voisin in G[s]:
            if voisin not in vus:
                vus.add(voisin)
                file.append(voisin)   # on enfile (droite)
    return ordre
B. Déroulé pas à pas depuis A
Appliquons parcours_largeur(G, 'A') sur notre graphe. Le point clé est de suivre l’état de la file à chaque tour de boucle.
| Étape | Sommet défilé | Voisins ajoutés | File après | Ordre de visite |
|---|---|---|---|---|
| 0 | — | A | [A] | — |
| 1 | A | B, C | [B, C] | A |
| 2 | B | D, E | [C, D, E] | A, B |
| 3 | C | — | [D, E] | A, B, C |
| 4 | D | — | [E] | A, B, C, D |
| 5 | E | — | [ ] | A, B, C, D, E |
Le parcours renvoie ['A', 'B', 'C', 'D', 'E']. Comme la file traite les sommets dans l’ordre d’arrivée, BFS visite d’abord les sommets les plus proches du départ : c’est pourquoi il donne le plus court chemin en nombre d’arêtes dans un graphe non pondéré.

Le second parcours, lui, plonge au plus profond avant de revenir en arrière.
IV. Parcours en profondeur (DFS)
Le parcours en profondeur (DFS, Depth-First Search) suit un chemin aussi loin que possible, puis « remonte » dès qu’il est bloqué. Il repose sur une pile (dernier entré, premier sorti). On peut l’écrire de deux façons.
A. Version itérative (avec une pile)
def parcours_profondeur(G, depart):
    vus = set()
    pile = [depart]
    ordre = []
    while pile:
        s = pile.pop()          # on dépile le dernier arrivé
        if s not in vus:
            vus.add(s)
            ordre.append(s)
            for voisin in G[s]:
                if voisin not in vus:
                    pile.append(voisin)
    return ordre
B. Version récursive
La récursivité exprime le plus naturellement l’idée « j’explore, puis je laisse chaque voisin explorer à son tour ». La pile d’appels de Python joue le rôle de la pile.
def dfs(G, s, vus=None):
    if vus is None:
        vus = set()
    vus.add(s)
    print(s)                    # traitement du sommet
    for voisin in G[s]:
        if voisin not in vus:
            dfs(G, voisin, vus)
    return vus
Erreur classique : écrire def dfs(G, s, vus=set()). En Python, une valeur par défaut mutable est partagée entre tous les appels : le set garderait les sommets du parcours précédent. Toujours utiliser vus=None puis créer l’ensemble à l’intérieur.
C. Quand utiliser BFS plutôt que DFS ?
C’est le tableau de décision à garder en tête : chaque parcours a son domaine de prédilection.
| Technique | Structure | Utiliser pour… | À éviter si… |
|---|---|---|---|
| BFS (largeur) | file | plus court chemin en nombre d’arêtes, test de connexité | les arêtes ont des poids |
| DFS (profondeur) | pile / récursion | détection de cycle, composantes connexes, tri topologique | chercher le plus court chemin pondéré |
| Dijkstra | file de priorité | plus court chemin avec poids positifs | présence de poids négatifs |
Ces deux parcours ne sont pas une fin en soi : ils servent à résoudre des problèmes concrets sur les graphes.
V. Applications : distances, connexité, cycles
Une fois BFS et DFS maîtrisés, trois applications tombent presque gratuitement.
A. Distances depuis un sommet (BFS)
Il suffit d’ajouter un dictionnaire de distances : chaque voisin découvert est à une arête de plus que le sommet courant.
from collections import deque

def distances(G, depart):
    d = {depart: 0}
    file = deque([depart])
    while file:
        s = file.popleft()
        for voisin in G[s]:
            if voisin not in d:
                d[voisin] = d[s] + 1
                file.append(voisin)
    return d
B. Tester la connexité
Un graphe est connexe si un seul parcours, lancé depuis n’importe quel sommet, atteint tous les autres. On compare donc le nombre de sommets vus au nombre total de sommets. Si le parcours n’atteint pas tout le monde, les sommets vus forment une composante connexe, et on en cherche d’autres depuis les sommets restants.
C. Détecter un cycle (DFS)
En DFS, si l’on retombe sur un sommet déjà « en cours d’exploration » (autre que le parent immédiat dans un graphe non orienté), c’est qu’il existe un cycle. C’est la base de la détection de dépendances circulaires.
Ces algorithmes relient directement l’informatique à des notions comme la matrice d’adjacence et les types de graphes étudiés en maths expertes.
VI. 🟠 Prépa (ITC) : du plus court chemin à Dijkstra
En prépa, les graphes deviennent pondérés : chaque arête porte un coût (distance, temps, prix). BFS ne suffit plus, car le chemin avec le moins d’arêtes n’est pas forcément le moins coûteux. L’algorithme de Dijkstra calcule le plus court chemin pour des poids positifs, en traitant à chaque étape le sommet le plus proche encore non fixé, grâce à une file de priorité (module heapq).
import heapq
from itertools import count

# Chaque sommet, y compris sans voisin, figure comme clé de G.
# G[s] contient des couples (voisin, poids fini positif ou nul).
def dijkstra(G, depart):
    if depart not in G:
        raise KeyError(depart)
    if any(poids < 0 for voisins in G.values() for _, poids in voisins):
        raise ValueError("Dijkstra exige des poids positifs ou nuls")
    ordre = count()  # évite de comparer les noms des sommets en cas d'égalité
    dist = {depart: 0}
    tas = [(0, next(ordre), depart)]
    while tas:
        d, _, s = heapq.heappop(tas)
        if d != dist[s]:
            continue  # une meilleure distance a été trouvée depuis l'insertion
        for voisin, poids in G[s]:
            nd = d + poids
            if voisin not in dist or nd < dist[voisin]:
                dist[voisin] = nd
                heapq.heappush(tas, (nd, next(ordre), voisin))
    return dist
Rédaction concours : sur une épreuve d’informatique, on attend que tu justifies le choix de la structure (file de priorité) et que tu donnes la complexité : \(O((n+m)\log n)\) avec un tas. Mentionner que Dijkstra échoue avec des poids négatifs est le réflexe qui distingue une bonne copie.
Avant de t’entraîner, voici les erreurs qui coûtent le plus de points — et de temps de débogage.
VII. Erreurs fréquentes
❌ Copie fautive : un BFS sans ensemble vus.
while file:
    s = file.popleft()
    for voisin in G[s]:
        file.append(voisin)   # on ré-enfile sans fin !
Diagnostic : sans marquage, un sommet est enfilé à chaque fois qu’on le rencontre → boucle infinie sur un graphe avec cycle.
✅ Correction : toujours tenir un ensemble vus et n’enfiler qu’un voisin not in vus.
- Confondre file et pile. BFS =
popleft()sur unedeque(file) ; DFS =pop()sur une liste (pile). Les inverser change complètement l’ordre de parcours. - Valeur par défaut mutable (
vus=set()) : partagée entre appels, elle fausse les parcours suivants (voir section IV.B). - Modifier le graphe pendant le parcours : ajouter ou retirer des clés de
Gdans la boucle provoque des erreurs ou des résultats imprévisibles. - Oublier la symétrie dans un graphe non orienté : si tu ajoutes l’arête A–B, pense à inscrire B chez A et A chez B.
Pour aller plus loin sur ce type de pièges, consulte les erreurs Python classiques en prépa.
VIII. Exercices corrigés
Quatre exercices pour t’entraîner, de la construction du graphe à l’algorithme complet. Essaie avant de dérouler la correction.
Exercice 1 — Construire le dictionnaire d’adjacence ★
Un graphe non orienté a pour arêtes : A–B, A–D, B–C, C–D, D–E. Écris le dictionnaire d’adjacence G correspondant.
Voir la correction de l’exercice 1
Pour chaque arête, on inscrit chaque extrémité dans la liste de l’autre (graphe non orienté).
G = {
    'A': ['B', 'D'],
    'B': ['A', 'C'],
    'C': ['B', 'D'],
    'D': ['A', 'C', 'E'],
    'E': ['D']
}
Vérification : l’arête D–E apparaît bien chez D ('E') et chez E ('D').
Exercice 2 — Calculer le degré d’un sommet ★
Écris une fonction degre(G, s) qui renvoie le nombre de voisins du sommet s, puis une fonction qui calcule le nombre total d’arêtes du graphe non orienté.
Voir la correction de l’exercice 2
Le degré est la longueur de la liste des voisins.
def degre(G, s):
    return len(G[s])

def nb_aretes(G):
    somme = sum(len(voisins) for voisins in G.values())
    return somme // 2   # chaque arête comptée deux fois
On divise par 2 car, dans un graphe non orienté, chaque arête est comptée une fois de chaque côté : c’est le lemme des poignées de main. La somme des degrés vaut le double du nombre d’arêtes.
Exercice 3 — Tester la connexité avec un BFS ★★
Écris une fonction est_connexe(G) qui renvoie True si le graphe est connexe, False sinon, en utilisant un parcours en largeur.
Voir la correction de l’exercice 3
On lance un BFS depuis un sommet quelconque, puis on compare le nombre de sommets atteints au nombre total.
from collections import deque

def est_connexe(G):
    if not G:
        return False  # convention : le graphe vide n’est pas connexe
    depart = next(iter(G))     # un sommet quelconque
    vus = {depart}
    file = deque([depart])
    while file:
        s = file.popleft()
        for voisin in G[s]:
            if voisin not in vus:
                vus.add(voisin)
                file.append(voisin)
    return len(vus) == len(G)
Idée clé : un seul parcours suffit. S’il n’atteint pas tous les sommets, le graphe a plusieurs composantes connexes et n’est donc pas connexe.
Exercice 4 — Plus court chemin en nombre d’arêtes ★★★
Écris une fonction plus_court(G, depart, arrivee) qui renvoie la liste des sommets d’un plus court chemin (en nombre d’arêtes) entre deux sommets, ou None s’il n’existe pas.
Voir la correction de l’exercice 4
On enrichit le BFS en mémorisant, pour chaque sommet, le prédécesseur qui l’a découvert. On remonte ensuite la chaîne de prédécesseurs depuis l’arrivée.
from collections import deque

def plus_court(G, depart, arrivee):
    pred = {depart: None}
    file = deque([depart])
    while file:
        s = file.popleft()
        if s == arrivee:
            break
        for voisin in G[s]:
            if voisin not in pred:
                pred[voisin] = s
                file.append(voisin)
    if arrivee not in pred:
        return None
    # reconstruction du chemin
    chemin = []
    s = arrivee
    while s is not None:
        chemin.append(s)
        s = pred[s]
    return chemin[::-1]
Pourquoi BFS ? Parce qu’il découvre les sommets par distance croissante : le premier chemin trouvé vers l’arrivée est forcément l’un des plus courts. Le chemin est reconstruit à l’envers, d’où le [::-1] final.
IX. Questions fréquentes
Qu’est-ce qu’un graphe en Python ?
C’est une structure de données qui modélise un ensemble de sommets reliés par des arêtes. En pratique, on le code le plus souvent avec un dictionnaire d’adjacence (chaque sommet est une clé, sa valeur est la liste de ses voisins) ou avec une matrice d’adjacence. Il n’y a pas de type « graphe » natif : on choisit sa représentation.
Quelle différence entre un graphe et un graphique en Python ?
Un graphe relève de la théorie des graphes (sommets, arêtes, parcours). Un graphique est une courbe ou un diagramme que l’on trace, généralement avec la bibliothèque matplotlib (fonction plot). Cette page traite uniquement des graphes au sens « réseaux de sommets », pas du tracé de courbes.
Faut-il utiliser une liste ou une matrice d’adjacence ?
Par défaut, le dictionnaire (liste) d’adjacence : il occupe une mémoire \(O(n+m)\), idéale pour les graphes creux. On préfère la matrice d’adjacence \(O(n^2)\) pour les graphes denses ou quand on veut exploiter le calcul matriciel, par exemple compter des chemins avec les puissances de la matrice.
BFS ou DFS : lequel choisir ?
Utilise BFS (file) pour le plus court chemin en nombre d’arêtes et les tests de connexité. Utilise DFS (pile ou récursion) pour détecter des cycles, trouver les composantes connexes ou faire un tri topologique. Pour un plus court chemin pondéré, ni l’un ni l’autre : Dijkstra convient si tous les poids sont positifs ou nuls ; des poids négatifs demandent une autre méthode.
Faut-il installer une bibliothèque comme networkx ?
Non, pas pour le programme de NSI ni pour les épreuves de prépa : on code tout « à la main » avec des dictionnaires, collections.deque et éventuellement heapq. La bibliothèque networkx est utile pour des projets ou de la visualisation, mais elle masque les algorithmes qu’on doit justement savoir écrire.
X. Pour aller plus loin
Tu sais maintenant représenter un graphe et le parcourir en largeur comme en profondeur. Pour relier ces algorithmes au cours de maths et approfondir :
- Inégalité de Markov : énoncé, démonstration et applications (du lycée à la prépa)
- Réussir les maths expertes en terminale et viser la prépa
- Probabilités Totales (Terminale) : Formule et Méthodes
- Le raisonnement par récurrence : principe, méthode et exemples
Tu veux progresser plus vite en NSI et en maths ? Découvre l’accompagnement Excellence Maths, du lycée à la prépa.
À propos du DFS : l’ordre de visite dépend de l’ordre des voisins et de la gestion de la pile. Les versions itérative et récursive peuvent donc donner des ordres différents, tous deux corrects. Pour un graphe très profond, la version récursive peut atteindre la limite de récursion de Python. La détection d’un cycle exige aussi une précaution : dans un graphe non orienté, exclure l’arête vers le parent ; dans un graphe orienté, distinguer un sommet encore actif d’un sommet déjà terminé.


